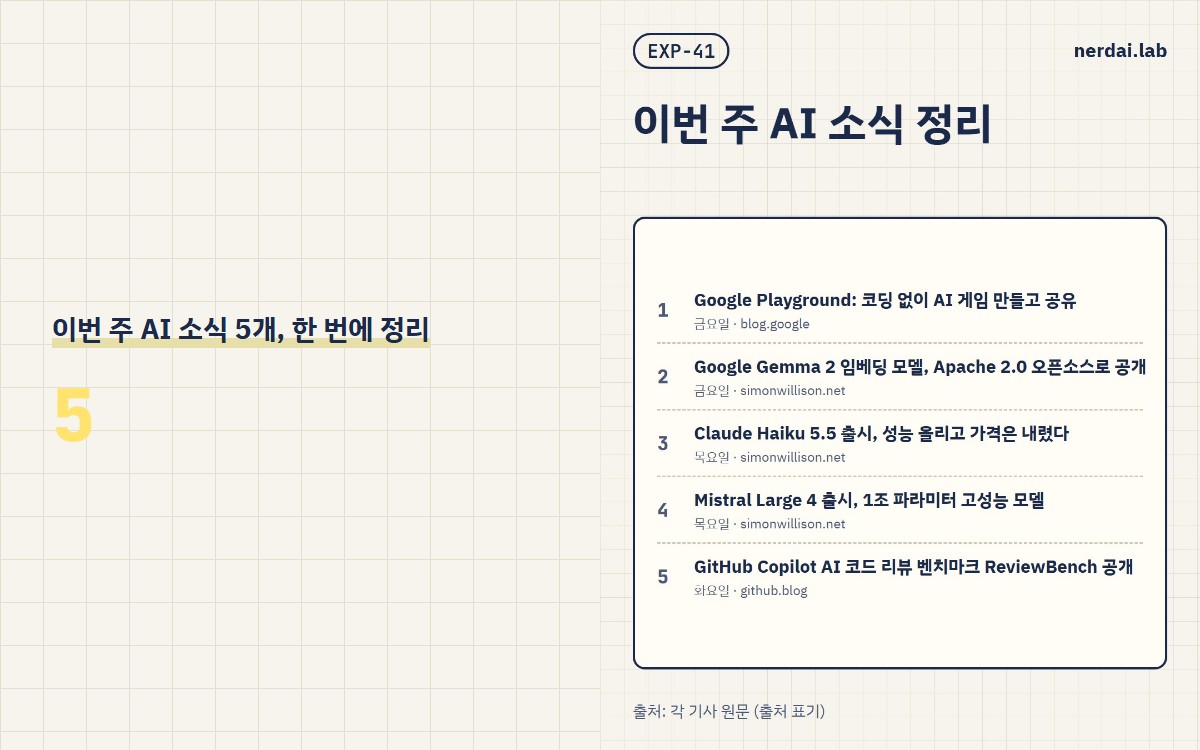
Claude Haiku 5.5는 성능을 올리고 가격은 내렸다고 해요. Google Playground, Gemma 2 임베딩, Mistral Large 4, ReviewBench까지 5개를 번호순으로 정리했어요.
Claude Haiku 5.5는 성능은 올리고 가격은 내렸다고 소개됐어요. 다만 인하 폭과 성능 비교 기준은 공식 요금표와 원문에서 확인해야 해요.
이번 주 소식은 5개예요. 아래 내용은 직접 돌려 본 결과가 아니라 발표와 기사 기준이에요.
한눈에 보기
| 번호 | 소식 | 발표 내용 | 독자가 살펴볼 변화 |
|---|---|---|---|
| 1번 | Google Playground (금요일) | 코딩 없이 AI 게임을 만들고 공유해요. | 개발자가 아니어도 결과물을 만들어 볼 수 있어요. |
| 2번 | Gemma 2 임베딩 모델 (금요일) | Apache 2.0 오픈소스로 공개됐어요. | 문서 검색을 직접 만들 때 선택지가 늘어요. |
| 3번 | Claude Haiku 5.5 (목요일) | 성능은 올리고 가격은 내렸어요. | API 단가를 다시 확인해 볼 수 있어요. |
| 4번 | Mistral Large 4 (목요일) | 1조 파라미터 고성능 모델이에요. | 모델 규모를 어떻게 읽을지 알아 둘 필요가 있어요. |
| 5번 | ReviewBench (화요일) | GitHub Copilot의 AI 코드 리뷰 벤치마크가 공개됐어요. | AI 코드 리뷰를 재는 기준이 하나 생겼어요. |
무엇이 나왔나
5개를 쓰임새별로 묶었어요. 번호와 이름은 위 표와 같아요.
직접 만들어 볼 때
1번 Google Playground (금요일)
코딩 없이 AI로 게임을 만들고, 만든 걸 공유할 수 있는 도구예요. 출처는 Google 공식 블로그예요.
2번 Gemma 2 임베딩 모델 (금요일)
임베딩은 글을 숫자 묶음으로 바꿔서 비슷한 글을 찾는 데 쓰는 방식이에요. 이 모델은 Apache 2.0 오픈소스로 공개됐어요.
모델 비용과 규모를 따질 때
3번 Claude Haiku 5.5 (목요일)
성능은 올리고 가격은 내렸다는 소식이에요. 인하 폭과 성능 비교 기준은 원문과 공식 요금표에서 확인해 보세요.
4번 Mistral Large 4 (목요일)
1조 파라미터를 가진 고성능 모델로 소개됐어요. 파라미터는 학습으로 정해지는 값의 개수예요. 모델 규모를 보여 주는 숫자예요.
코드 리뷰를 맡길 때
5번 ReviewBench (화요일)
GitHub가 Copilot의 AI 코드 리뷰를 재려고 공개한 벤치마크예요. 벤치마크는 여러 도구에 같은 문제를 내고 결과를 견주는 시험지 같은 거예요. 시험 방식과 점수는 GitHub 블로그 원문에서 확인해 보세요.
왜 중요한가
1번은 코딩을 못 하는 직장인도 AI로 게임을 만들고 공유해 볼 수 있다는 점이 달라졌어요. 2번은 Apache 2.0 라이선스라서, 사내 문서 검색을 직접 만들려는 개발자에게 선택지가 하나 늘어난 셈이에요. 구체적인 사용 조건은 라이선스 문구로 확인해야 해요.
3번은 API 이용자가 공식 단가를 확인해 사용 비용을 다시 계산해 볼 수 있다는 점이 달라졌어요. 구독 요금까지 내렸는지는 따로 확인이 필요해요.
5번은 AI 코드 리뷰를 쓰는 팀이 "잘 잡아 주나?"를 막연한 느낌이 아니라 공개된 기준으로 따져 볼 출발점이 돼요.
써 보면
써 보기 전에 확인할 것을 번호별로 정리했어요.
- 1번 Playground: 공유 범위와 사용 조건은 Google 공식 안내에서 확인해요.
- 2번 Gemma 2 임베딩: 배포 페이지에서 설치 방법과 요구 사양을 확인해요. Apache 2.0 문구도 같이 읽어요.
- 3번 Haiku 5.5: 공식 요금표에서 입력·출력 단가를 확인해요. 구독 요금과 API 요금은 따로 매겨져요.
- 4번 Mistral Large 4: 이용 방식과 요금은 제공처 공식 페이지에서 확인해요.
- 5번 ReviewBench: GitHub 블로그 원문에서 무엇을 어떻게 재는지 먼저 읽어요.
숫자 바르게 읽기
이번 주에 숫자로 나온 건 4번의 1조 파라미터예요. 모델이 크다는 뜻이지, 내 업무를 더 잘 풀어 준다는 뜻은 아니에요.
다른 모델과의 비교가 없으니 우열은 말하지 않을게요. 모델을 바꿀지는 규모만으로 정할 수 없어요. 내 작업 결과와 이용 비용을 나란히 놓고 비교해야 해요.
5번 같은 벤치마크 점수도 같은 방식으로 읽어요. 어떤 문제로 쟀는지 알아야 내 코드에 맞는 점수인지 알 수 있어요.
남은 불확실성
이 글은 발표와 기사를 정리한 것이고, 5개를 직접 써 보지는 않았어요. 3번의 가격 인하 폭과 성능 비교 기준, 4번의 이용 방법, 5번의 시험 방식과 결과는 아직 확인되지 않았어요. 1번과 2번의 세부 제한도 원문에서 직접 보셔야 해요.
그래서 달라진 것
이번 주에 바로 해 볼 일은 하나예요. Haiku 5.5의 공식 단가와 비교 기준부터 확인하세요. 그 값이 있어야 내 사용량에서 비용이 어떻게 달라지는지 계산할 수 있어요.
기준일: 2026-10-10. 발표와 기사 내용 기준이며, 가격과 조건은 바뀔 수 있어요.