한 번에 더 긴 자료를 검색용으로 처리할 수 있어요. 텍스트·코드·이미지·비디오·오디오를 한 벡터 공간에 담는 온디바이스 모델의 숫자와 라이선스를 정리했어요.
한눈에 보기
- 구글이 10월 6일(현지시간) 임베딩젬마 2를 공개했어요.
- 컨텍스트는 최대 8192토큰이고, 전작의 4배예요.
- 전체 740M 매개변수, Gemma 4 아키텍처 기반이에요.
- Apache 2.0 라이선스라 상업적 활용이 가능해요.
임베딩젬마 2는 한 번에 최대 8192토큰을 받아요. 전작보다 4배 늘어난 값이에요.
독자에게 생기는 변화는 단순해요. 긴 문서나 여러 자료를 잘게 쪼개는 횟수를 줄이고, 한 번에 더 긴 자료를 검색용으로 처리할 수 있어요. 이 글은 발표와 국내 기사 기준이고, 직접 돌려 본 결과는 없어요.
한 번에 처리하는 자료가 늘었어요
전작 임베딩젬마는 누적 2000만 회 이상 내려받혔다고 해요. 이번 2편은 텍스트와 코드에 이미지, 비디오, 오디오를 더해 하나의 임베딩 공간에서 처리해요. 구글은 자사의 첫 온디바이스 임베딩용 네이티브 멀티모달 오픈 모델이라고 소개했어요.
바뀐 점을 [항목 / 전작→이번 변화 / 활용 의미]로 줄이면 이래요.
- 컨텍스트 / 전작의 4배, 최대 8192토큰 / 긴 자료를 덜 쪼개고 처리해요.
- 입력 종류 / 텍스트 중심에서 코드·이미지·비디오·오디오까지 / 서로 다른 형태를 한 공간에서 비교해요.
- 한 번에 넣는 양 / 이미지 29장, 비디오 프레임 58개, 오디오 5.5분 / 여러 형태를 섞어 넣을 수 있어요.
- 구조 / 텍스트·코드 270M, 비전 170M, 오디오 300M / 필요한 부분만 골라 써요.
왜 중요한가
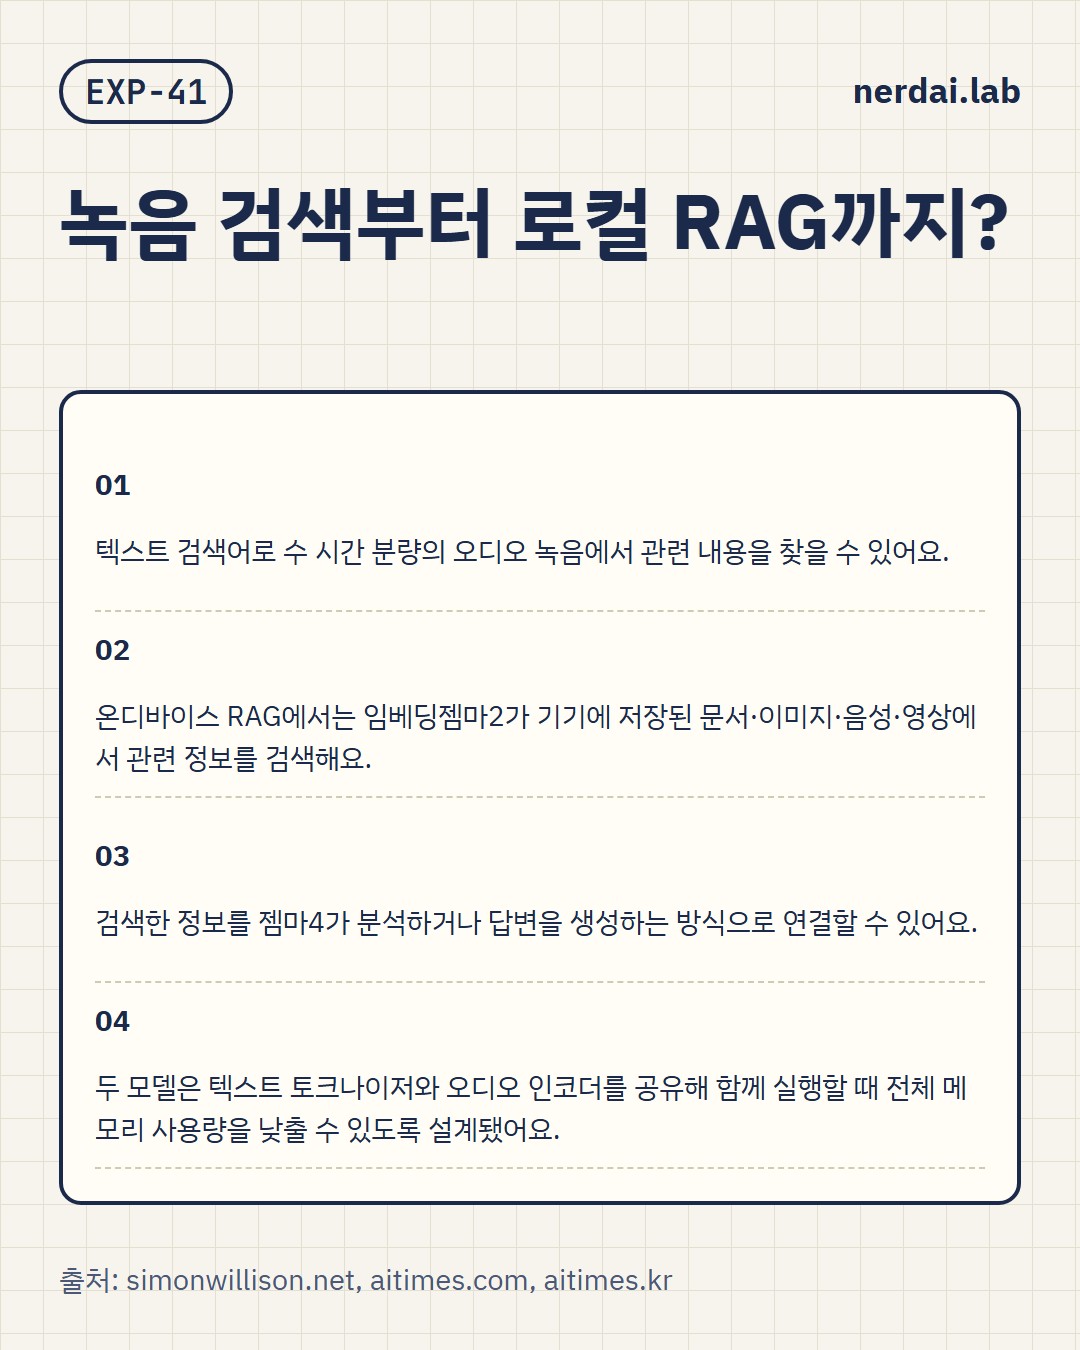
텍스트로 사진을 찾고, 음성 메모로 비디오 장면을 찾는 검색을 한 모델로 만들 수 있어요. 기사에 나온 예시예요.
기기 안에서 돌릴 수 있어서 데이터를 외부 서버로 보내지 않아도 돼요. 개인정보나 오프라인 환경이 걱정인 팀에는 선택지가 하나 늘어난 셈이에요.
서비스가 끝나도 같은 모델을 계속 쓸 수 있어요
Simon Willison은 Hacker News에 Apache 2.0 라이선스를 환영한다고 남겼어요. 이건 그의 의견이에요.
이유는 이래요. 임베딩은 수천, 수백만 개를 계산해 저장해 두고 나중에 비교하는 용도가 많아요. 폐쇄형 모델은 언젠가 서비스가 끝날 수 있고, 그러면 저장한 벡터를 다시 계산하는 비용이 들어요.
그는 직접 호스팅은 원치 않는다고 했어요. 호스팅 서비스를 쓰다가 중단되면 오픈 가중치로 직접 돌리거나 다른 업체를 찾을 수 있는 구조가 좋다는 입장이에요. 2024년 4월에 OpenAI가 재임베딩 비용을 부담하겠다고 한 적이 있지만, 모든 업체에서 기대할 일은 아니라고 봤어요.
가중치는 허깅페이스와 캐글에서 내려받을 수 있어요. 요금 정보는 이번 자료에 없었어요.
숫자 바르게 읽기
MTEB 코드 점수는 전작 68.76에서 78.68로 올랐어요. 기사에 따르면 9.92점 차이예요. 로컬 코드베이스 색인이나 코딩 에이전트용 검색을 만드는 분께 의미가 있는 숫자예요.
다만 이 점수만으로 텍스트·이미지 검색 품질의 향상 폭까지 알 수는 없어요.
구글은 10억 매개변수 미만 멀티모달 임베딩 모델 중 규모 대비 성능이 좋다고 설명했어요. 더 큰 모델과 동등하거나 앞서는 결과도 제시했다고 해요. 어떤 모델과 어떤 점수로 비교했는지는 이번 자료에 없어요.
740M은 전체 합계예요. 270M, 170M, 300M을 모두 켰을 때의 규모이고, 텍스트만 쓰면 270M 부분만 쓰면 돼요.
남은 불확실성
- 구글은 양자화 모델의 픽셀 11 프로 활성 RAM을 텍스트 전용 약 191MB, 전체 약 567MB로 제시했어요. 다른 기기의 속도·메모리는 별도 확인이 필요해요.
- 비교 대상 모델과 구체적인 점수표는 공식 자료로 확인해야 해요.
- 저는 직접 돌려 보지 않았어요.
그래서 달라지는 것
임베딩을 쓰는 서비스를 만든다면 오픈 가중치와 Apache 2.0 조합 덕에 선택지가 생겨요. 호스팅이 중단돼도 같은 모델을 직접 실행하거나 다른 제공업체에서 이어 쓸 수 있어요.
다른 모델로 바꾸면 기존 벡터를 다시 계산해야 할 수 있어요. 먼저 내 데이터로 작은 샘플 검색을 돌려 보고 판단해 보세요.
기준일: 2026년 10월 9일. 공식 발표를 인용한 국내 기사와 개인 블로그 의견을 맞춰 정리했어요.